 Mental Bound
Τι είναι η vector database;
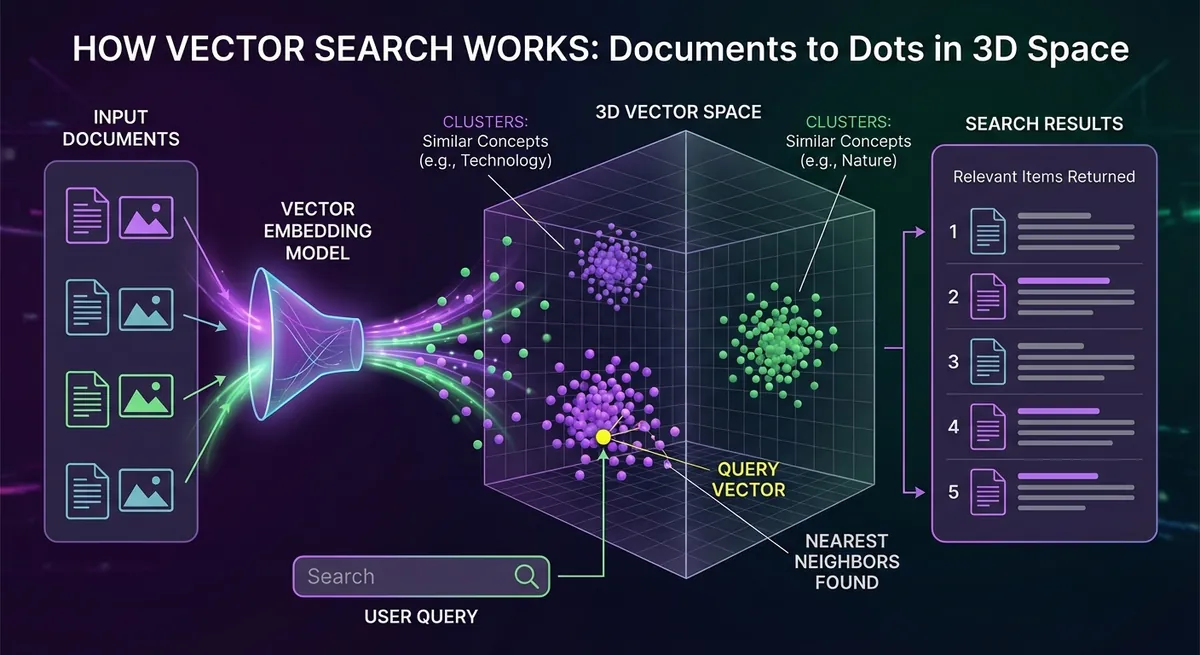
Οι παραδοσιακές βάσεις δεδομένων υπερέχουν σε ακριβή αντιστοίχιση και ερωτήματα εύρους. Οι vector databases είναι φτιαγμένες για ένα διαφορετικό πρόβλημα: να βρίσκουν στοιχεία που είναι παρόμοια με ένα vector ερωτήματος. Αποθηκεύουν embeddings — αριθμητικές αναπαραστάσεις κειμένου, εικόνων ή άλλων δεδομένων — και υποστηρίζουν approximate nearest neighbor search σε κλίμακα.
Πώς λειτουργεί η vector database;
Όταν κάνεις embed ένα ερώτημα χρήστη και αναζητάς τα πλησιέστερα document embeddings, κάνεις σημασιολογική ανάκτηση: αντιστοίχιση βάσει νοήματος, όχι λέξεων-κλειδιών. Vector databases όπως Pinecone, pgvector και Weaviate βελτιστοποιούν γι' αυτό. Χρησιμοποιούν δομές ευρετηρίασης (HNSW, IVF) για να κάνουν την αναζήτηση ομοιότητας γρήγορη ακόμα και με εκατομμύρια vectors. Απαραίτητες για RAG, recommendations και κάθε εφαρμογή που χρειάζεται «βρες πράγματα σαν αυτό».
Πού εμφανίζεται στη δουλειά μας;
Για τα περισσότερα συστήματα RAG που χτίζουμε, η σωστή vector database είναι η βάση που ο πελάτης ήδη τρέχει: το pgvector μέσα στην Postgres χειρίζεται εκατομμύρια embeddings πριν μια εξειδικευμένη υπηρεσία αποσβέσει το κόστος της. Περνάμε σε hosted ή self-hosted engine όταν το απαιτούν η κλίμακα, το filtering ή οι κανόνες data residency. Τα Δεδομένα & Αναλύσεις καλύπτουν το pipeline των embeddings και τη συντήρηση του ευρετηρίου, και οι Λύσεις AI & Αυτοματισμού το retrieval layer από πάνω.